 MIRO 팀
Ollama 0.40.17 사전판, 내장 GPU 로딩과 동시 요청 처리의 변화
정식 업데이트 전에 살펴볼 두 변화
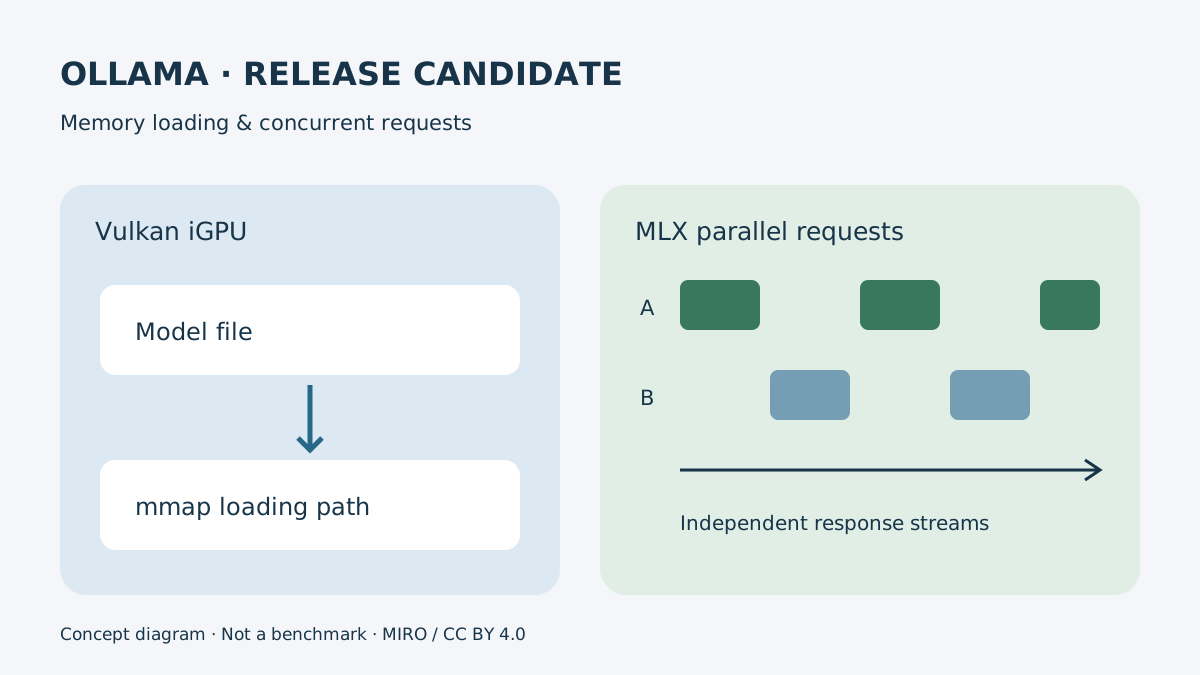
Ollama의 v0.40.17-rc0 사전 릴리스에는 Vulkan 내장 GPU의 모델 로딩 수정과 MLX의 동시 생성 지원이 들어갔습니다. 공식 페이지의 제목은 v0.40.17이지만, 태그와 공개 상태는 출시 후보판입니다. 따라서 운영 중인 프로그램에 바로 적용하기보다 별도 환경에서 확인할 변경으로 보는 편이 좋습니다. 여기서는 릴리스와 병합된 수정 설명을 대조했으며 직접 실행한 성능 측정은 포함하지 않습니다.
내장 GPU에서 로딩이 실패하던 이유
내장 GPU는 보통 CPU와 시스템 메모리를 함께 사용합니다. 이번 수정 설명에 따르면 기존의 비메모리 매핑 로딩은 CPU에 남을 모델 데이터도 Vulkan의 호스트 버퍼에 넣었습니다. 이 버퍼가 모델 가중치와 같은 장치 메모리 예산을 쓰면서 공유 메모리 환경에서는 점유량이 크게 늘어날 수 있었습니다. 용량이 남아 보이는데도 고정 메모리 할당 실패나 Windows AMD 환경의 예외로 로딩이 중단되는 문제와 연결됩니다.
수정은 해당 Vulkan 경로에서 모델 파일을 메모리에 연결하는 mmap 방식을 사용하도록 바꿉니다. 직접 입출력 방식만으로는 호스트 버퍼 문제가 사라지지 않는다는 설명도 함께 제시됐습니다. 이는 특정 로딩 경로의 불필요한 부담을 줄이는 변화입니다. 모든 내장 GPU에서 큰 모델을 실행할 수 있게 됐다거나 생성 속도가 일정 비율로 빨라졌다는 뜻으로 확대할 근거는 없습니다.
두 사람이 기다릴 때 MLX가 달라집니다
MLX 모델은 OLLAMA_NUM_PARALLEL 설정을 통해 여러 생성 요청을 함께 처리할 수 있게 됩니다. 기본값은 여전히 한 요청입니다. 동시에 처리할 때 일부 계산은 묶지만 요청별 대화 캐시, 샘플링 상태와 응답 흐름은 구분합니다. 한 요청의 답변이 끝날 때까지 다른 요청이 전부 기다리는 상황을 줄이려는 변경입니다.
다만 대기 시간이 줄어드는 것과 전체 처리량이 늘어나는 것은 다릅니다. 개발자가 공개한 Apple M5 Max 시험에서는 두 번째 요청이 답변을 받기 시작하는 시점이 당겨졌지만, 일부 모델은 두 요청을 모두 끝내는 시간이 늘었습니다. 복수 요청 중에는 추측 디코딩을 잠시 멈추는 제한도 있습니다. 동시 요청 수를 높이면 각 요청에 필요한 메모리까지 고려해야 합니다.
같은 조건으로 비교해 보세요
Vulkan 환경에서는 이전 버전과 후보판에 같은 모델, 입력 길이와 GPU 설정을 적용해 로딩 성공 여부부터 비교하는 것이 좋습니다. 전체 RAM 사용량과 오류 로그를 함께 남겨야 모델 크기 차이를 수정 효과로 착각하지 않습니다. 로딩이 성공해도 긴 대화에서 필요한 추가 메모리와 실제 생성 속도는 별도로 확인할 항목입니다.
MLX 환경에서는 요청 하나와 두 개를 나누어 첫 응답까지 걸린 시간, 모든 응답의 완료 시간, 메모리 최고 사용량을 비교해 보세요. 여러 작업을 밤새 순서대로 처리하는 목적이라면 동시 실행이 반드시 유리하지는 않습니다. 이번 후보판은 새 모델의 지능 향상보다 로컬 실행 도구의 자원 사용과 대기 방식이 달라지는 소식으로 이해하면 됩니다.
댓글
이 글에 대한 생각을 남겨 주세요.