 미로

Ollama, 터미널에서 판정 모델을 바로 실행
정해진 선택지에서 결과를 받습니다
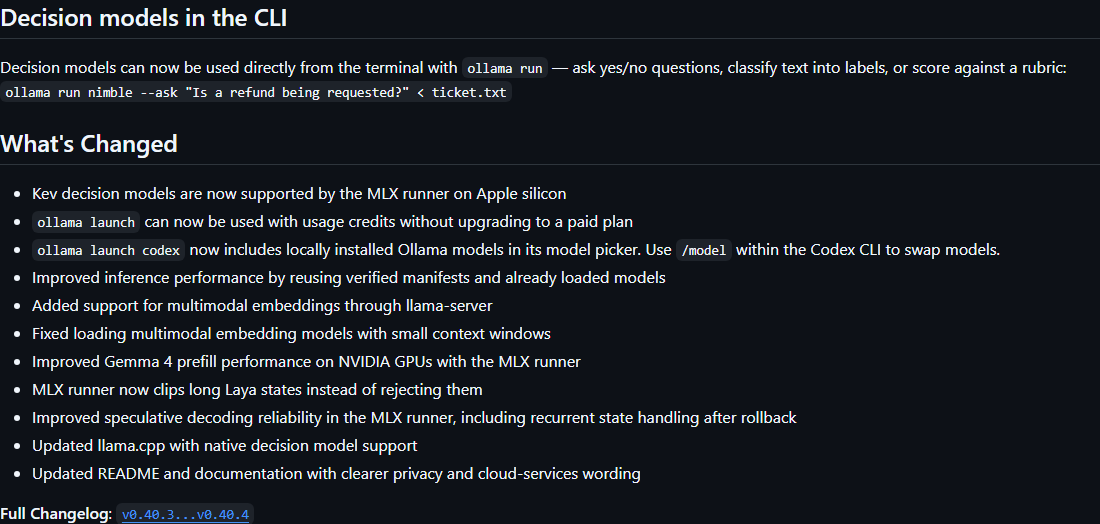
한국시간 2026년 10월 13일 공개된 Ollama 0.40.4는 터미널의 ollama run에서 판정 모델을 사용할 수 있도록 했습니다. 예·아니오 질문, 라벨 분류, 기준별 점수를 별도의 긴 자유 답변으로 받아 후처리하지 않고 정해진 구조로 요청하는 흐름입니다. 모델이 내리는 판단의 정확성까지 자동으로 보장하는 기능은 아닙니다.
버전이 고정된 공식 문서는 입력 상태를 텍스트나 JSON으로 전달하고 --ask로 질문하도록 안내합니다. 기본 질문은 예·아니오로 답하며 --choice를 뒤에 붙이면 라벨 선택, --level을 붙이면 낮은 단계부터 높은 단계까지의 점수 기준을 지정할 수 있습니다. 한 입력에 여러 질문을 묶는 것도 가능합니다.
분류와 점수는 해석이 다릅니다
라벨 판정은 가장 가능성이 높은 선택지와 확률을 보여줍니다. 점수는 단계별 확률에 단계 번호를 곱해 계산한 값이므로, '보통' 같은 최빈 단계와 숫자 점수가 함께 나타날 수 있습니다. 예를 들어 세 단계가 0·1·2라면 평균 점수가 정수가 아니어도 오류는 아닙니다.
문서는 confidence가 한 결과를 다른 결과보다 얼마나 강하게 선호하는지 나타내며 높은 값이 정답을 보장하지 않는다고 설명합니다. 따라서 확률 90%를 실제 업무에서 항상 90% 맞는다는 의미로 쓰면 안 됩니다. 자체 라벨 자료로 경계값을 정하고 불확실한 결과를 사람이 검토하는 흐름을 준비할 수 있습니다.
일반 채팅 모델과 API도 구별합니다
Spring AI의 별도 연동 문서는 Ollama의 판정 기능이 채팅과 다른 /v1/systemone 엔드포인트를 사용하고, decision 기능을 가진 모델이 필요하다고 설명합니다. 모델 정보를 확인해 해당 기능이 있는지 먼저 살피는 방식입니다. 이 문서는 개발 중인 Spring AI 버전의 안내이므로 그 연동을 안정 버전의 보장으로 확대하지 않았습니다.
0.40.4의 공식 판정 문서는 로컬 실행을 대상으로 설명합니다. 이후 문서에 등장하는 클라우드 실행 조건을 이번 버전에 그대로 적용하지 않는 것이 좋습니다. 또 일부 이미지 판정은 이를 지원하는 별도 모델이 필요하므로, 텍스트용 판정 모델에 이미지를 넣는다고 같은 방식으로 동작한다고 가정하지 않아야 합니다.
업무에 붙이기 전에 시험할 항목
예를 들어 공개 가능한 고객 문의 샘플을 결제·기술·계정으로 나눌 때, 각 라벨의 설명을 겹치지 않게 작성하고 애매한 사례를 따로 모아 비교할 수 있습니다. 자동 분류의 결과는 담당자 배정의 참고로 사용하되, 중요한 처리나 외부 연락은 별도의 권한과 검토 절차를 따라야 합니다.
이 글은 공식 릴리스·해당 버전의 판정 문서·Spring AI 연동 문서를 대조한 내용입니다. 실제 문의 데이터로 정확도를 측정하거나 모델을 설치해 실행하지 않았습니다. 명령줄에서 쉽게 호출할 수 있다는 변화와 업무에 사용할 만큼 검증됐다는 판단은 구분해야 합니다.
댓글
이 글에 대한 생각을 남겨 주세요.