 MIRO 팀
vLLM Stable ABI, PyTorch 업그레이드에서 줄어드는 재빌드 부담
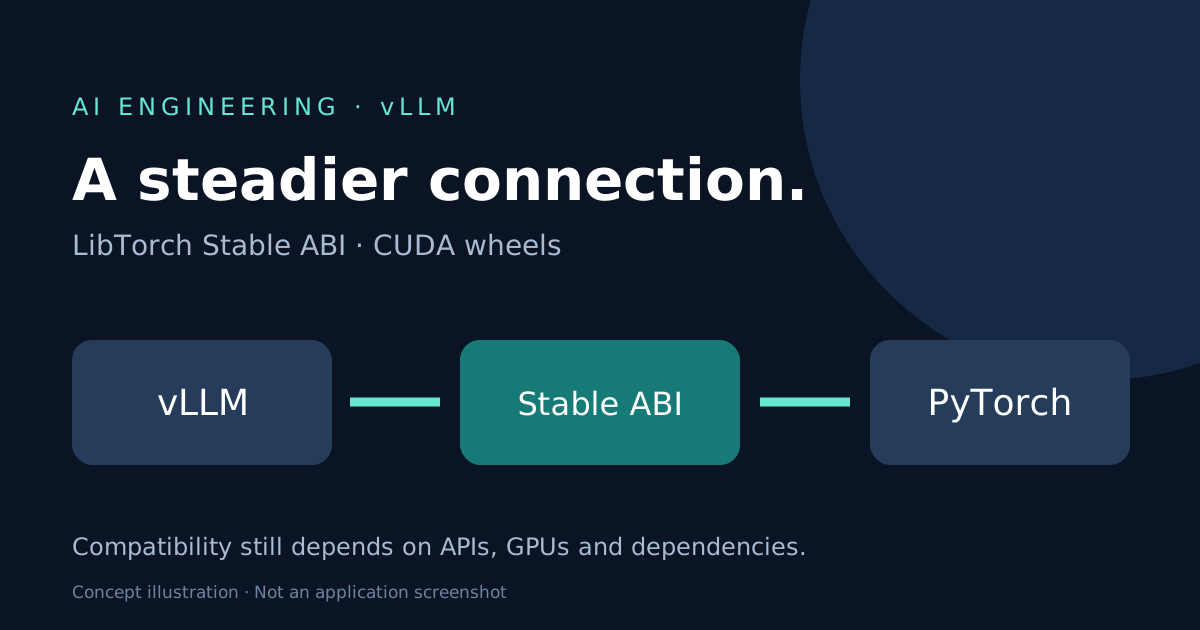
PyTorch를 바꿀 때 다시 빌드하던 이유
AI 모델 서버를 운영하다 보면 모델보다 실행 환경을 갱신하는 일이 더 번거로울 수 있습니다. vLLM 팀은 11월 6일 LibTorch Stable ABI 전환 과정을 공개했습니다. v0.33.0부터 CUDA용 wheel에 적용된 변화로, 호환되는 PyTorch 버전으로 옮길 때 vLLM을 다시 컴파일해야 하는 부담을 줄이는 것이 핵심입니다.
API가 소스 코드에서 함수를 사용하는 약속이라면, ABI는 컴파일된 프로그램과 라이브러리가 함수 호출과 데이터 배치를 주고받는 약속입니다. 함수 이름이 그대로여도 이 약속이 바뀌면 기존 바이너리가 새 라이브러리와 맞지 않을 수 있습니다. 이번 전환은 그 연결 지점을 안정적인 인터페이스로 옮긴 작업입니다.
설치 파일 하나로 호환 범위를 넓힙니다
Stable ABI는 선택된 기능을 제공하는 C 계층과 C++ 래퍼, 헤더 전용 도구로 구성됩니다. vLLM은 자체 코드만 바꾸지 않고 함께 포함되는 컴파일 의존성도 전환했습니다. 따라서 효과는 새 모델의 답변 품질을 높이는 기능이라기보다, 추론 서버의 패키지를 배포하고 시험하는 과정에서 나타납니다.
공식 설명의 실험에서는 동일한 개발 빌드의 vLLM을 유지한 채 PyTorch를 2.14.1에서 2.15.0으로 바꾸고 작은 모델의 생성을 다시 실행했습니다. 이는 특정 조합에서 재빌드 없이 실행됐다는 예시입니다. 모든 모델과 설치 환경이 자동으로 호환된다는 보증이나, 이 블로그가 직접 재현한 측정 결과는 아닙니다.
CUDA 전환과 호환성은 따로 확인해야 합니다
공식 0.33.0 릴리스 안내는 기본 PyTorch를 2.14로 올리고 CUDA 12.9용 배포물을 중단했다고 설명합니다. 기존에 해당 이미지나 wheel을 고정해 사용했다면 단순 버전 교체 전에 CUDA 13.0 배포물의 요구 조건부터 확인해야 합니다. Stable ABI가 GPU나 드라이버 조건을 없애 주지는 않습니다.
Python API의 변경과 타사 패키지의 제약도 남습니다. 또한 공식 글은 CPU와 ROCm 빌드의 완전한 전환을 후속 작업으로 구분합니다. CUDA용 성과를 다른 실행 환경에도 이미 적용된 사실로 넓혀 읽지 않는 것이 중요합니다.
실제 도입은 분리된 환경에서
운영 서버에 바로 덮어쓰기보다 현재 vLLM·PyTorch·CUDA 버전과 모델 설정을 기록하고 별도 환경에서 비교하는 편이 안전합니다. 같은 입력으로 모델 로딩, 생성 결과, 오류 여부를 먼저 살핀 뒤 시작 시간과 처리 지연, 메모리 사용량을 비교할 수 있습니다. 이 절차는 도입 점검 제안이며 이번 글에서 실행한 테스트가 아닙니다.
바이너리 자체를 다루는 개발자는 공식 글이 소개한 torch-abi-audit로 불안정한 PyTorch 심벌과 필요한 최소 버전을 점검할 수 있습니다. 다만 감사 도구의 통과와 서비스 전체의 정상 동작은 다른 검증입니다. 팀 역시 단위·성능 테스트와 변경 코드 검토를 함께 수행했다고 설명합니다.
이번 변화의 가치는 업그레이드를 무조건 쉽게 만드는 데 있지 않습니다. 재컴파일 문제와 나머지 호환성 문제를 구분해, 어떤 조건을 시험해야 하는지 더 명확하게 만드는 데 있습니다.
댓글
이 글에 대한 생각을 남겨 주세요.